一、网站概况
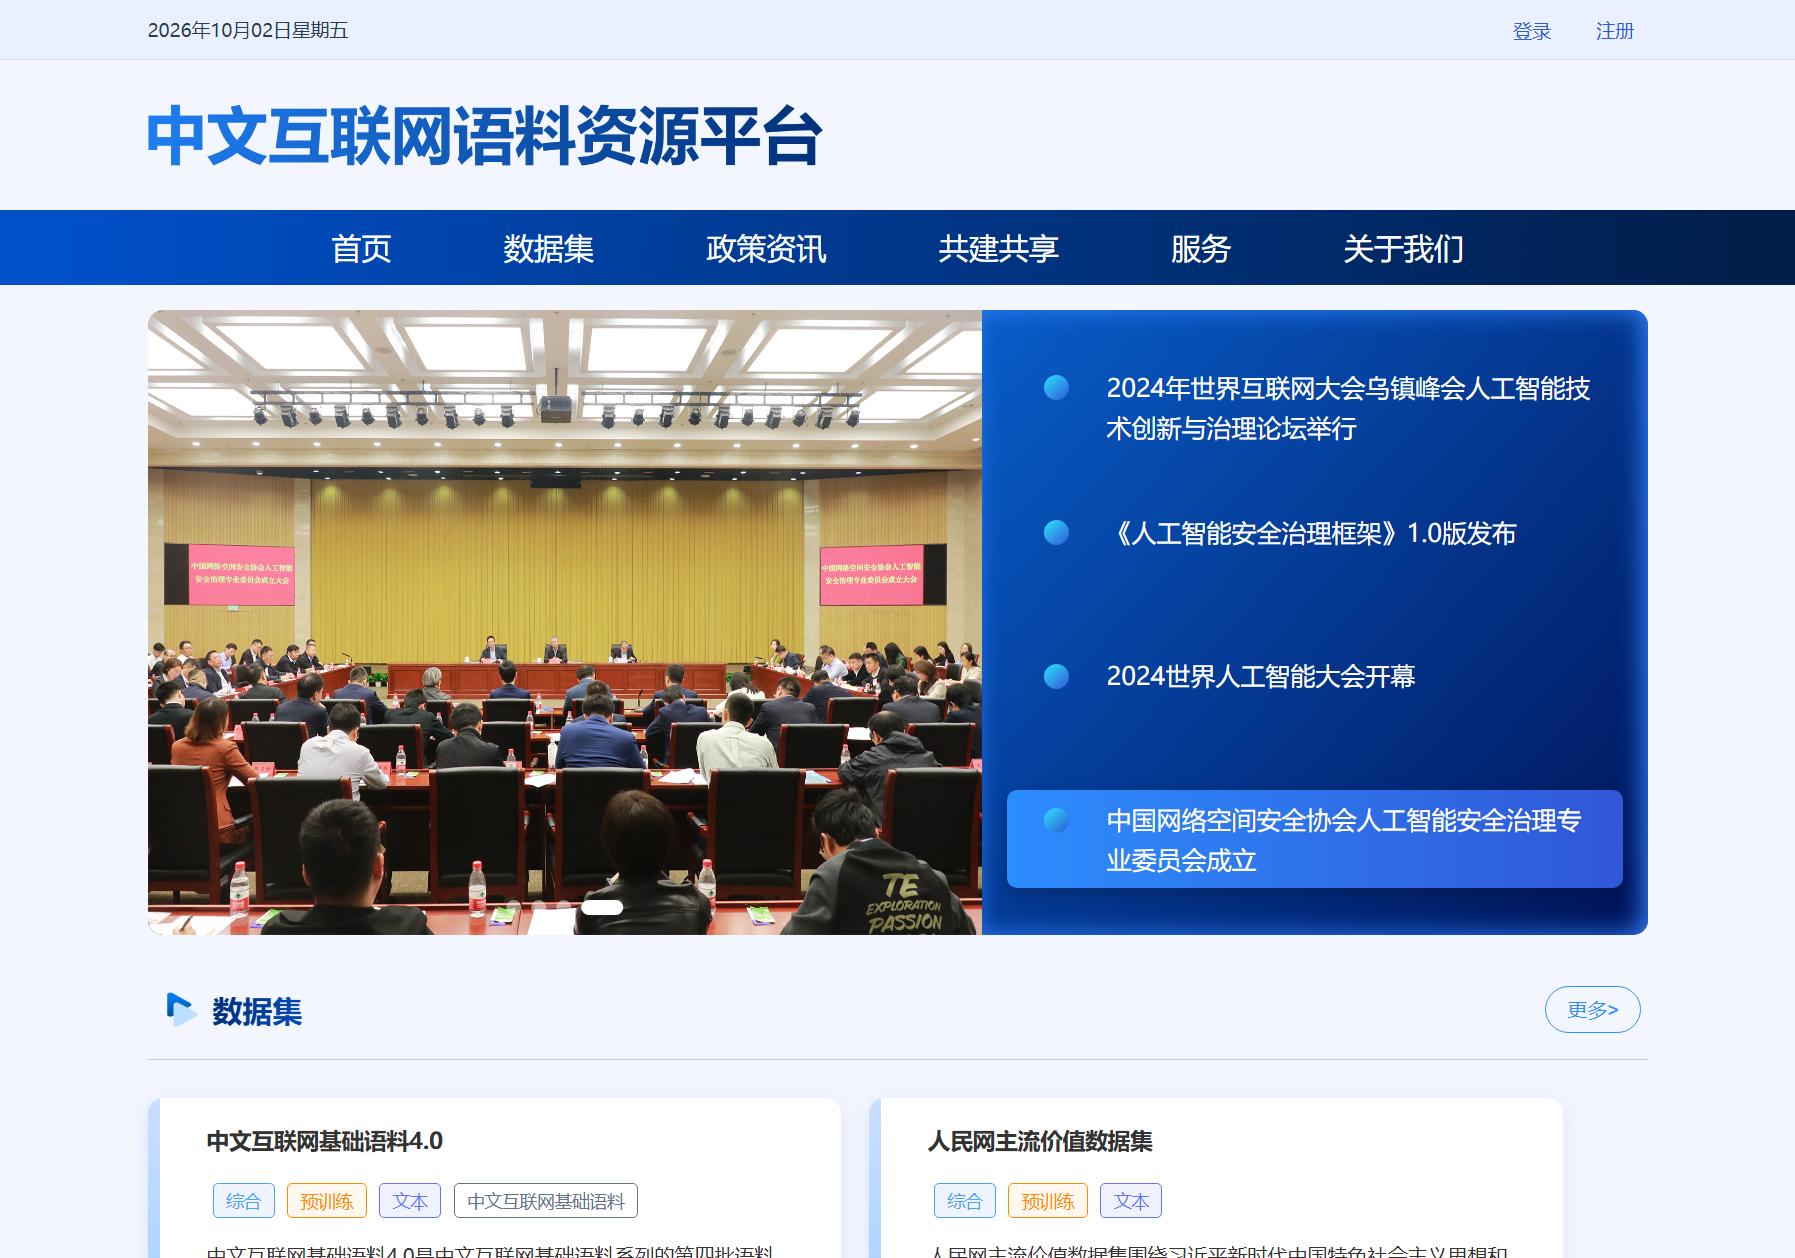
中文互联网语料资源平台(https://corpus.cybersac.cn/?home#/)是由中国网络空间安全协会主办的公益性语料共享平台,网站定位是为人工智能大模型研发提供高质量、安全合规的中文训练语料,同时汇总人工智能安全治理相关的政策资讯。平台依托“共建—共享”机制,联合国家权威机构、企业、高校和科研单位,持续建设中文互联网基础语料系列。目前公开的数据集包括中文互联网基础语料4.0、人民网主流价值数据集、国家版本馆明清文献语料、国家哲学社会科学文献中心中文期刊数据集等,覆盖预训练、价值观对齐、古籍文化、学术期刊等多个领域。
二、核心功能详解
数据集浏览与下载:这是平台的核心功能。进入“数据集”栏目后,用户可以看到每个数据集的详情页,包括数据来源、数据量、格式、字段说明和更新时间。以中文互联网基础语料4.0为例,页面明确标注120GB,并说明该语料经过信源筛选、违法不良信息过滤、低质内容过滤、数据去重等步骤处理,适合用于大模型预训练。
政策资讯聚合:网站首页和“政策资讯”栏目集中发布人工智能安全治理相关的法律法规、政策文件、峰会动态等内容。例如《人工智能安全治理框架》1.0版、人工智能生成合成内容标识办法等,方便从业者快速了解监管要求。
共建共享机制:平台设有“共建共享”入口,面向企业、高校和科研单位开放,鼓励各方提交高质量语料或参与建设。这种协同模式既补充了数据来源,也让语料更贴近产业实际需求。
三、使用教程/操作指南
第一步,访问网站首页,无需登录即可浏览“数据集”和“政策资讯”,查看数据集简介和元数据。第二步,点击感兴趣的数据集进入详情页,查看数据量、格式、清洗步骤和示例字段。第三步,如需下载全部数据,点击下载或申请按钮,注册并登录账号。注册时需填写基本信息,部分数据集可能需审核或签署使用协议。第四步,下载后根据说明解压使用,注意文件格式:基础语料多为JSON或TXT,人民网数据集为JSON,国家版本馆语料为TXT(按书种导出)。小技巧:下载前先看字段说明,确认是否包含所需字段;政策资讯无需登录,适合做合规调研时快速查阅。
四、内容与资源质量
平台的数据来源权威,均来自国家权威机构或主流媒体:中国网络空间安全协会指导,人民网提供主流价值数据,国家版本馆提供明清文献,中国社会科学院提供期刊元数据。数据处理规范,基础语料4.0明确列出信源筛选、隐私过滤、内容过滤等步骤。资源量方面,目前公开数据集数量不多,但覆盖了预训练、价值观、古籍、学术四个关键方向,且中文互联网基础语料已迭代至4.0,说明有持续更新。版权上,平台备案号为津ICP备19007168号,数据来源合法,但下载后的使用范围需遵守各自数据集的使用协议。
五、适用人群与场景
适合人群:大模型预训练团队、AI算法工程师、自然语言处理研究者、高校科研人员、需要中文语料做微调或评测的从业者。不适合人群:普通网民寻找文章素材、无技术背景的个人、需要实时新闻资讯的用户。
具体场景举例:① 某大模型团队需要补充120GB高质量中文预训练语料,直接下载中文互联网基础语料4.0;② 某AI公司做模型价值观对齐和意识形态安全评测,使用人民网主流价值数据集的问答语料和基础语料;③ 某高校中文系研究明清文献,下载国家版本馆明清文献语料做文本分析。
六、优缺点分析
优点:数据权威合规,清洗标准高;免费开放(需注册),降低研发门槛;多领域覆盖,尤其适合中文场景;政策资讯集中,方便安全合规参考。
不足:数据集总量偏少,更新以批次为主,频率不算高;部分数据集只提供示例,并非全量数据;下载可能需要审核或签署协议,有一定使用门槛。
| 对比项 | 中文互联网语料资源平台 | Hugging Face | 和鲸社区 |
|---|---|---|---|
| 数据来源 | 国家权威机构、主流媒体 | 全球开放社区 | 国内竞赛与开源 |
| 中文合规性 | 高,经过法律合规过滤 | 需自行审查 | 中等 |
| 数据量 | 数十GB级,精而少 | PB级,海量 | 中等 |
| 免费程度 | 免费但需注册/审核 | 大部分免费 | 部分免费 |
数据统计
数据评估
本站凯洛导航提供的中文互联网语料资源平台都来源于网络,不保证外部链接的准确性和完整性,同时,对于该外部链接的指向,不由凯洛导航实际控制,在2026年10月2日 下午2:04收录时,该网页上的内容,都属于合规合法,后期网页的内容如出现违规,可以直接联系网站管理员进行删除,凯洛导航不承担任何责任。
相关导航