
VITREK
工业级测试与测量设备制造商的官方产品展示平台
 Scrapy-抓取和网络爬网框架
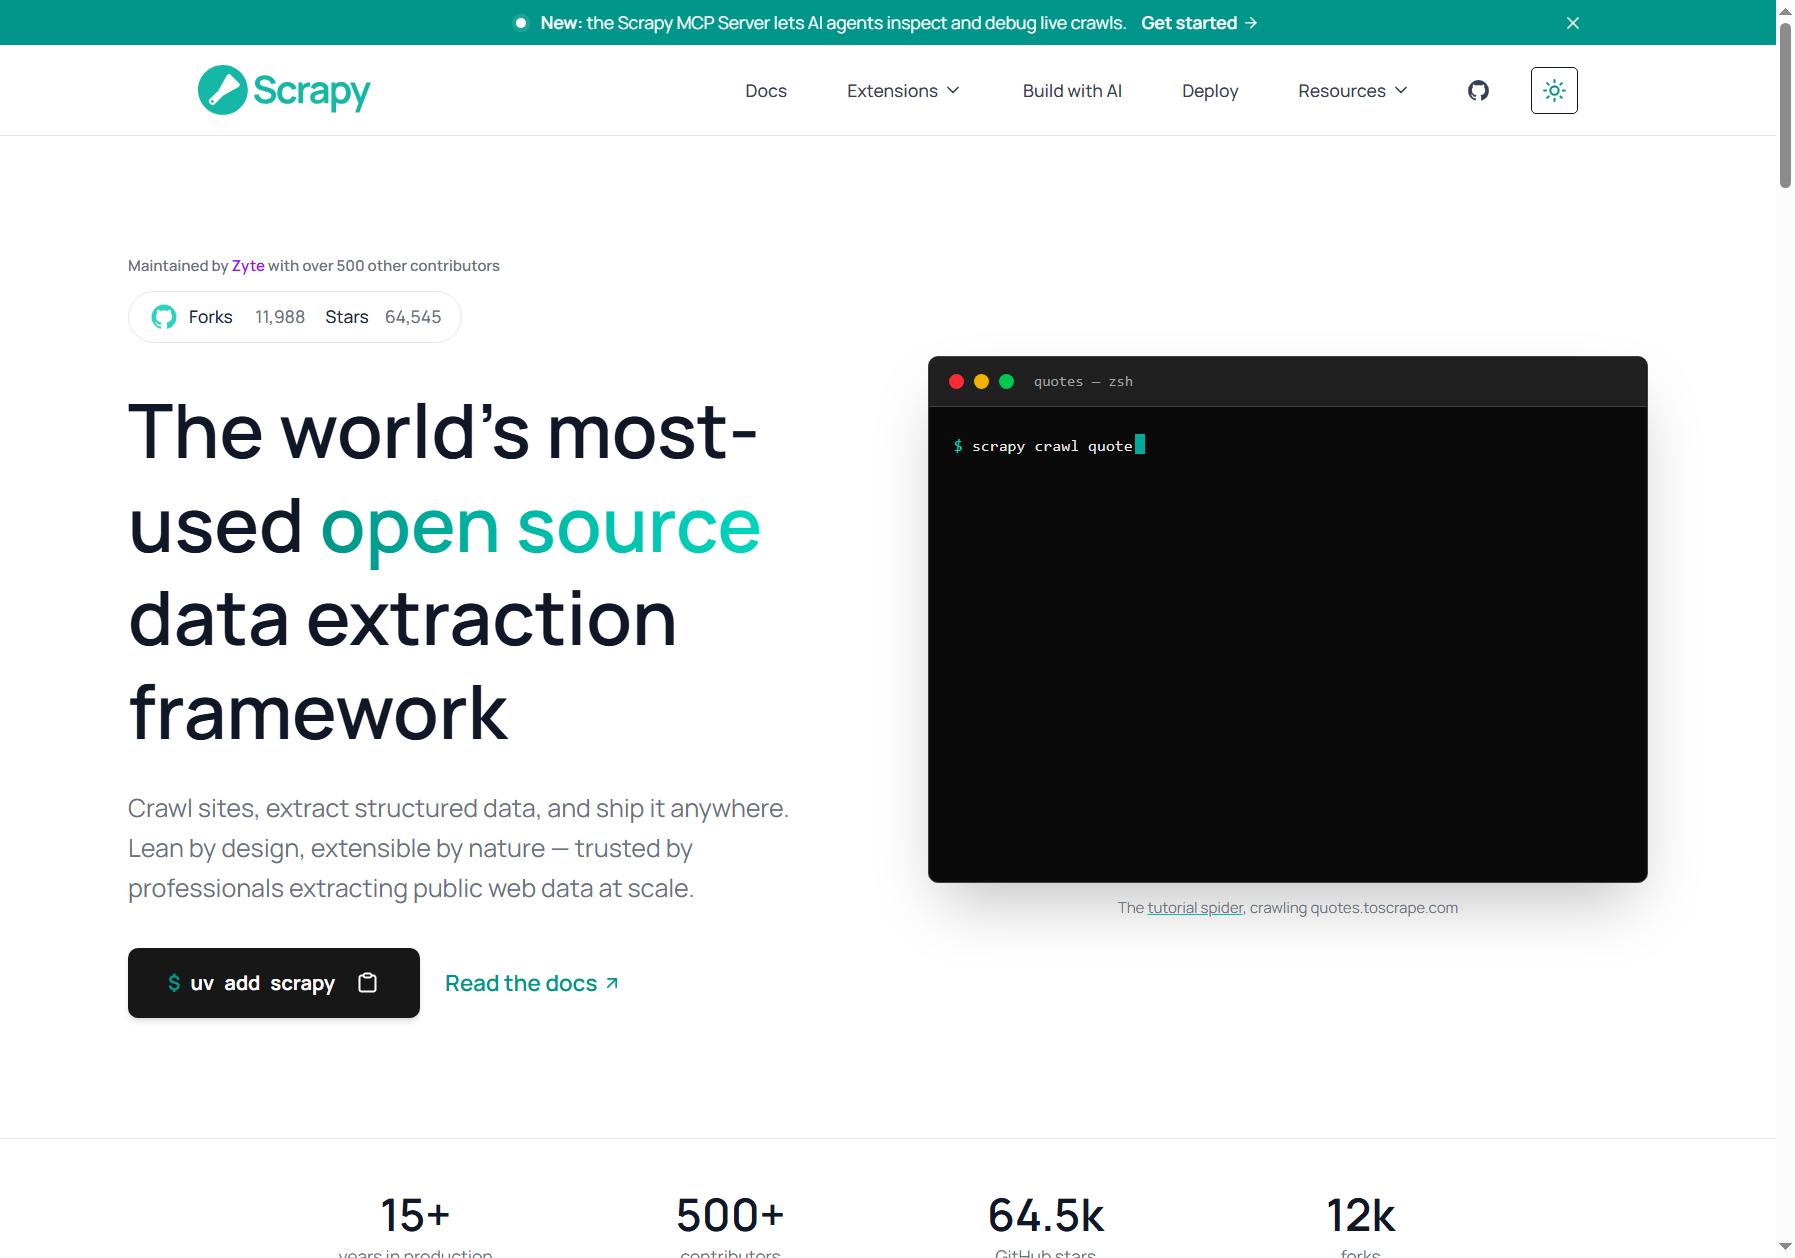
Scrapy 是一个开源的网页抓取与网络爬虫框架,也是目前全球使用量最大的 Python 数据提取工具。它由 Zyte 公司(原 Scrapinghub)主导维护,同时拥有超过 500 名社区贡献者参与开发,在 GitHub 上已获得约 64,500 颗星标和近 12,000 次分叉。
该项目自 2010 年前后发布以来,已经稳定迭代了 15 年以上,最新版本为 2026 年 9 月推出的 v2.19.0。Scrapy 的定位很明确:让开发者能够用最少的代码,把公开网页上的信息结构化地抓取下来,再导出到 JSON、CSV、数据库或云端存储中。它不是普通的“点几下鼠标就出结果”的可视化工具,而是一套面向程序员的完整开发框架。
异步抓取引擎
Scrapy 的核心是一套基于异步 I/O 的下载引擎,由调度器、下载器、爬虫、Item、管道和饲料导出六个可插拔模块组成。简单来说,它可以同时发出大量网页请求,而不需要等上一个请求完成才发下一个,因此抓取效率远高于普通的脚本写法。对一个有几十万页的网站,它能以分钟级完成全站遍历。
选择器与交互式 Shell
框架内置了 CSS 和 XPath 选择器,用来精准提取网页中的文字、链接、图片地址等元素。官网提供了一个交互式 Shell,你可以在终端里输入 scrapy shell "网址",直接把某个页面加载进来,现场测试选择器表达式是否写对了,确认无误后再把它写进爬虫代码里,省去反复试错的麻烦。
管道与数据导出
抓到的数据会先经过管道(Pipeline)做清洗、去重、校验,然后通过“饲料导出”功能一键输出为 JSON、CSV、XML 等格式,甚至可以直接推送到 Amazon S3 这类云存储。如果数据需要入库,也可以在管道里写几行代码接到 MySQL 或 MongoDB。
扩展插件体系
Scrapy 本体保持精简,额外能力通过插件补充。官方和社区提供了一批成熟扩展:scrapy-playwright 用于渲染依赖 JavaScript 的页面,spidermon 负责监控爬虫运行并在出错时发告警,scrapy-zyte-api 提供自动代理轮换和反封禁能力。2026 年新推出的 Scrapy MCP Server 还能让 AI 智能体直接连接正在运行的爬虫,实时查看状态和调试。
第一步:安装
Scrapy 基于 Python,需要先安装 Python 3.9 以上版本。官方推荐用 uv add scrapy 安装,传统的 pip install scrapy 也可以。安装完成后,在终端输入 scrapy version 能显示版本号就说明成功了。
第二步:创建项目
在命令行进入你想放代码的目录,执行 scrapy startproject quotes,框架会自动生成一个项目文件夹,里面包含爬虫、管道、设置等骨架文件。
第三步:编写爬虫
进入项目目录后,用 scrapy genspider quotes quotes.toscrape.com 生成一个爬虫模板,然后在 parse 方法里用 CSS 或 XPath 选择器提取数据,用 yield 把结果返回。官方教程用几行代码就能抓完一个网站上的名言和作者信息。
第四步:运行与导出
执行 scrapy crawl quotes -o quotes.jsonl,爬虫开始运行,抓取结果会实时写入 JSON 文件。整个过程中,终端会输出每一条请求的状态日志,方便排查问题。
小技巧:不确定选择器怎么写时,先用 scrapy shell 交互环境测试;需要跟翻页时,代码里用 response.follow_all 自动跟随“下一页”链接即可。
注意事项:抓取前务必查看目标网站的 robots.txt 和使用条款,控制请求频率,避免给目标服务器造成压力。
Scrapy 的资料体系非常成熟。官方文档覆盖了从入门教程、API 参考到各类主题指南,内容详细且持续维护,是学习该框架最权威的来源。项目采用 BSD 开源许可证,代码完全免费、可商用、可修改。
更新频率方面,项目保持着稳定的发布节奏:仅 2026 年下半年就发布了 v2.17.0、v2.18.0、v2.19.0 三个版本,涉及安全修复、HTTP/2 支持、新的远程控制扩展等。社区知识库中还沉淀了大量第三方教程、博客和实践案例,Stack Overflow 和 Discord 上的问题响应也比较及时。需要注意,教程和插件中有一部分由 Zyte 公司提供,其中涉及 Zyte API 的付费服务属于商业产品,但框架本体及其所有核心功能永久免费。
适合的人群
不太适合的人群
典型使用场景
优点
不足
与常见竞品简单对比
| 工具 | 定位 | 上手难度 | 适合场景 |
|---|---|---|---|
| Scrapy | 完整爬虫框架 | 中高 | 大规模、工程化采集 |
| BeautifulSoup | HTML 解析库 | 低 | 单页或小规模抓取 |
| Selenium | 浏览器自动化 | 中 | 需模拟用户操作的页面 |
| 八爪鱼等工具 | 零代码采集 | 低 | 非技术用户简单需求 |
本站凯洛导航提供的Scrapy-抓取和网络爬网框架都来源于网络,不保证外部链接的准确性和完整性,同时,对于该外部链接的指向,不由凯洛导航实际控制,在2026年10月2日 下午8:03收录时,该网页上的内容,都属于合规合法,后期网页的内容如出现违规,可以直接联系网站管理员进行删除,凯洛导航不承担任何责任。
是的,Scrapy 完全免费。它采用 BSD 开源许可证发布,任何人都可以免费下载、使用、修改,甚至用于商业项目。框架本身没有任何收费功能,只有 Zyte 公司提供的一些增值插件(如自动代理服务 Zyte API)属于可选的付费商业服务,不使用也不影响框架的正常功能。
基本不能。Scrapy 是一个面向开发者的框架,需要编写 Python 代码来定义爬虫逻辑和数据提取规则。如果你完全没有编程基础,建议先花两周左右学习 Python 基础,或者改用八爪鱼、Web Scraper 这类零代码工具处理简单需求。
可以。登录类需求可以通过在请求中携带 Cookie、表单提交等方式实现。对于依赖 JavaScript 动态加载的页面,可以配合 scrapy-playwright 插件,在真实浏览器中渲染页面后再提取数据。不过这类场景的配置复杂度会明显高于普通静态网页。
有可能。目标网站的反爬机制(如频率限制、IP 封禁)会影响抓取。Scrapy 本身提供了下载延迟、并发控制等基础配置,可以降低被封风险;对于严格反爬的网站,可以搭配 scrapy-zyte-api 插件使用自动代理轮换和浏览器指纹模拟。此外,抓取前务必遵守目标网站的服务条款和 robots 协议。
两者的定位不同。BeautifulSoup 只是一个 HTML 解析库,负责从网页源码中提取数据,你需要自己处理请求、翻页、去重等问题。Scrapy 则是一整套框架,把请求调度、并发下载、数据提取、结果导出全部封装好了。简单来说,抓几页数据用 BeautifulSoup 更轻便;做长期、大规模、多站点的采集,Scrapy 更适合。