TensorFlow开源机器学习平台
Google开源的端到端机器学习平台,支持从模型训练到多端部署的完整工作流。
 飞桨 PaddlePaddle
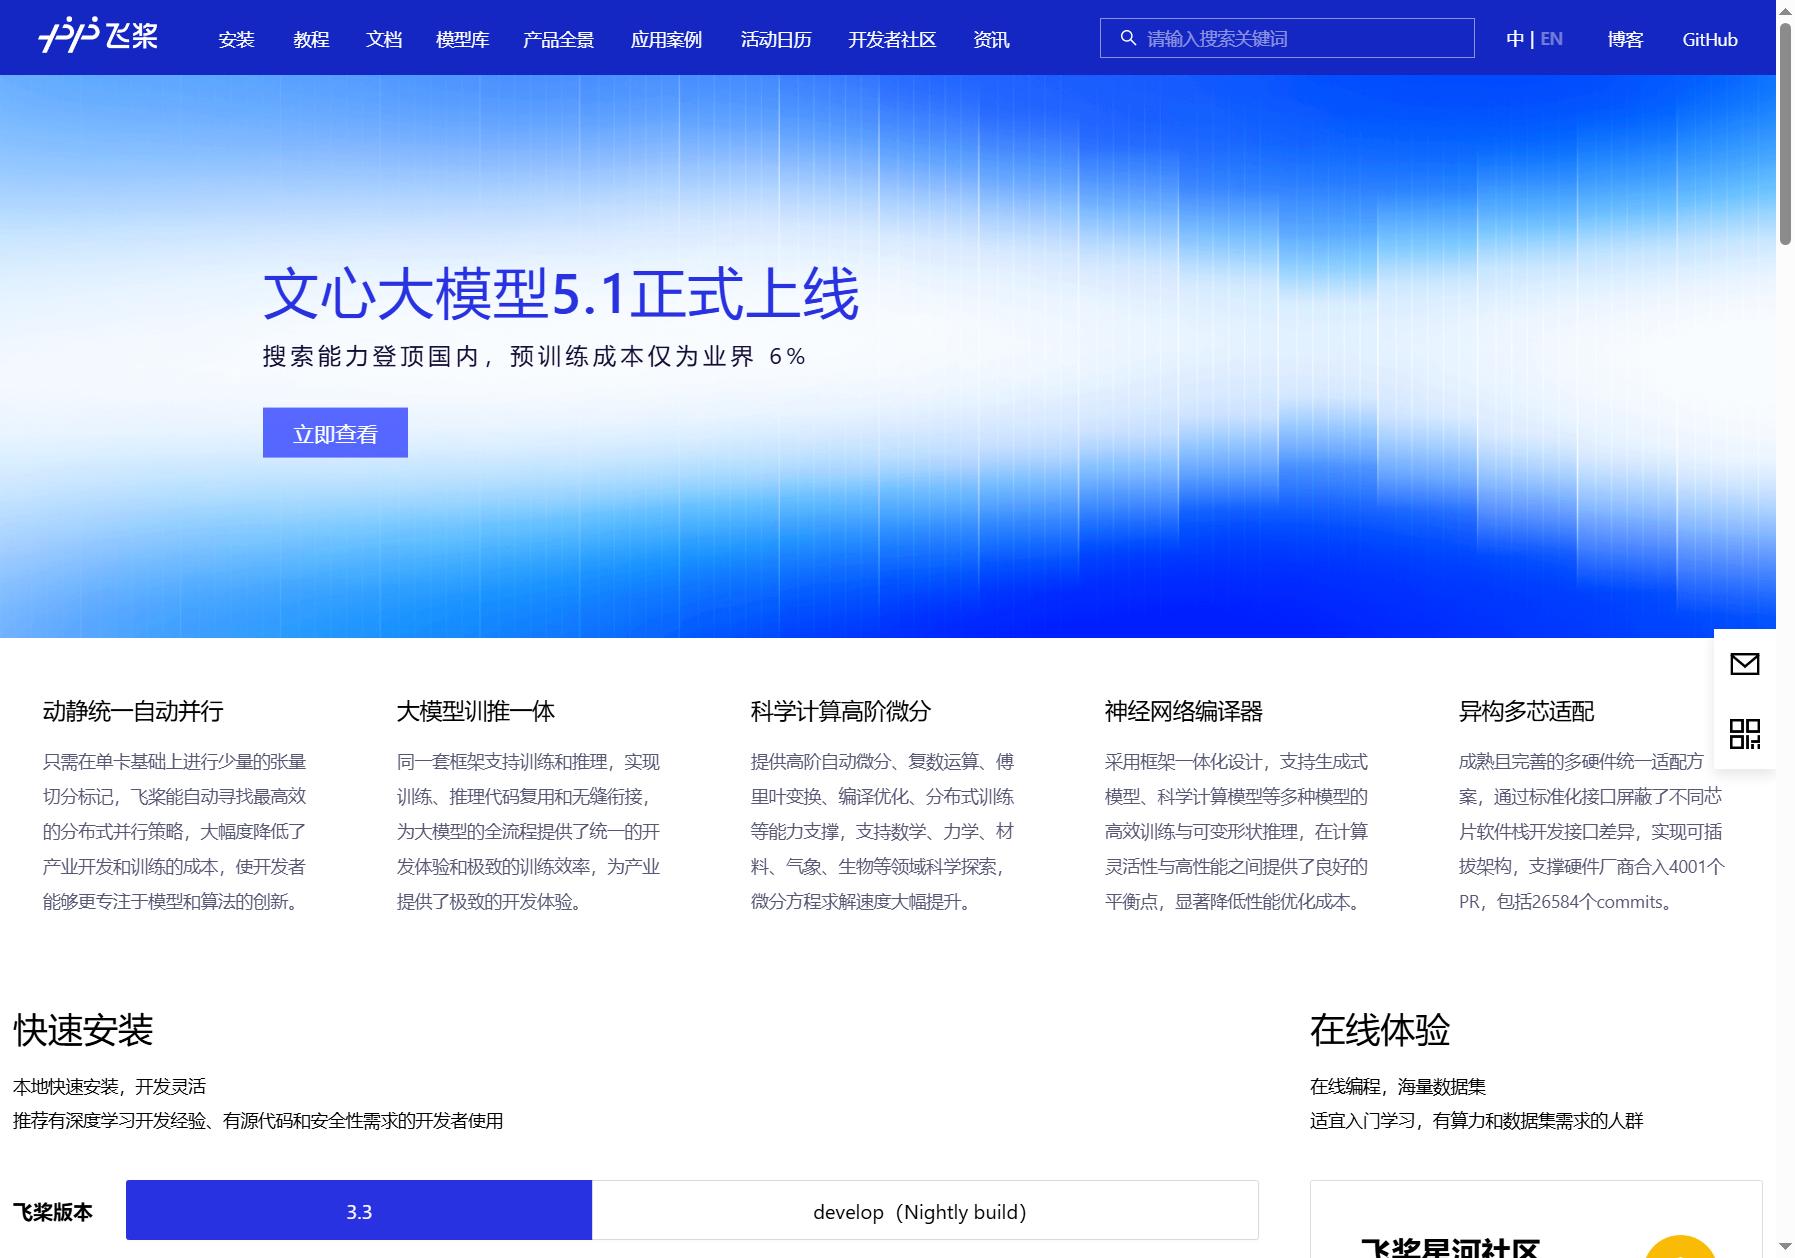
飞桨(PaddlePaddle)是百度自主研发的中国首个开源深度学习平台,2016年正式对外开源,运营方为百度在线网络技术(北京)有限公司。网站定位是集深度学习框架、开发套件、模型库、算力服务与开发者社区于一体的综合性AI开发平台,核心服务涵盖从模型训练、推理部署到产业落地的全流程。
截至2025年,飞桨平台已汇聚超过600个产业级开源算法模型,开发者规模突破千万级,服务企事业单位数十万家。2025年4月发布的飞桨框架3.0版本,标志着平台正式进入大模型时代,全面支持大模型训推一体、自动并行、科学计算等前沿能力,是国内功能覆盖最完整、生态最活跃的深度学习平台之一。
动静统一自动并行
飞桨框架提供业内领先的动静统一开发体验。开发者只需在单卡代码的基础上添加张量切分标记,框架即可自动分析模型结构,寻找最高效的分布式并行策略。这一功能大幅降低了大模型分布式训练的技术门槛,让开发者无需手动编写复杂的并行通信代码,即可将精力集中在模型和算法创新上。
大模型训推一体
飞桨3.0采用同一套框架同时支持训练和推理,开发者编写的训练代码可以直接复用于推理部署环节,无需二次开发。该设计为大模型提供了统一的开发体验,训练到推理无缝衔接,显著缩短了模型上线周期。配合神经网络编译器,支持生成式模型和科学计算模型的高效训练与可变形状推理,在灵活性和高性能之间取得良好平衡。
科学计算高阶微分
针对AI for Science场景,飞桨提供高阶自动微分、复数运算、傅里叶变换、编译优化、分布式训练等专项能力,可支撑数学、力学、材料、气象、生物等领域的科学探索。以工程结构中的薄板弯曲问题为例,微分方程求解速度较传统方法大幅提升,为科研人员提供了高效的数值计算工具。
异构多芯适配
飞桨建立了成熟完善的多硬件统一适配方案,通过标准化接口屏蔽不同芯片软件栈的开发接口差异,实现可插拔架构。目前支持英伟达、昆仑芯、海光、寒武纪、昇腾、燧原、太初、沐曦、天数等十余家芯片厂商,硬件厂商已合入4001个PR,包含26584个commits,是国内硬件生态兼容性最强的深度学习框架。
第一步:选择使用方式
飞桨提供两条主要使用路径。新手或算力受限的用户建议使用飞桨星河社区,在线编程环境免配置,提供免费GPU算力和丰富数据集;有深度学习经验、需要本地开发和源码级定制的用户,可选择本地安装飞桨框架。
第二步:本地安装配置
访问飞桨官网首页的”快速安装”区域,依次选择飞桨版本(推荐稳定版3.3)、操作系统(Windows/macOS/Linux)、安装方式(pip/docker/源码编译)、芯片厂商(英伟达/昆仑芯/海光/寒武纪等)和计算平台(CUDA版本或各芯片SDK),系统会自动生成对应的安装命令,复制到终端执行即可完成安装。
第三步:使用开发套件
根据任务场景选择对应的开发套件。文字识别与文档解析使用PaddleOCR,目标检测使用PaddleDetection,大语言模型开发使用PaddleNLP,多模态模型开发使用PaddleMIX。各套件均提供预训练模型和示例代码,以PaddleOCR为例,一行命令即可完成图片文字识别。
第四步:模型训练与部署
在星河社区或本地环境中准备数据集,使用套件提供的训练脚本进行模型微调。训练完成后,通过FastDeploy工具链进行模型压缩和推理部署,支持端边云多硬件平台,即训即用。
使用技巧:安装时优先匹配本机CUDA版本,避免版本不一致导致的报错;首次使用某个套件前,建议先运行官方提供的Notebook示例,熟悉API结构后再进行自定义开发。
飞桨平台的模型库资源规模在国内同类平台中处于领先地位,算法总数超过600个,覆盖图像分类、目标检测、语义分割、自然语言处理、语音识别、推荐系统等主流AI方向,所有模型均以Apache 2.0协议开源,免费商用无限制。
文档体系分层次建设:新手可通过”教程”板块的由浅入深课程体系快速上手;进阶开发者可查阅API文档和设计文档;产业开发者可参考应用案例获取落地经验。模型库更新频率较高,2025年先后发布了文心大模型5.1、ERNIE-4.5-VL-28B-A3B-Thinking等重量级开源模型。在正版合规性上,所有代码和模型均为百度官方或社区贡献者原创开源,不涉及盗版问题。
适合人群:高校学生和AI初学者,可通过星河社区免费算力和精品课程入门;AI算法工程师,需要高性能训练框架和丰富的预训练模型加速研发;科研人员,利用科学计算模块进行微分方程求解和数值模拟;企业开发者,需要国产自主可控的深度学习平台进行业务落地。
典型使用场景:
不适合人群:对PyTorch生态有重度依赖且迁移成本过高的团队;需要极端小众学术模型支持的独立研究者(飞桨模型覆盖广度仍不及PyTorch社区)。
优点:
不足:
| 对比维度 | 飞桨PaddlePaddle | PyTorch | TensorFlow |
|---|---|---|---|
| 中文文档 | ★★★★★ | ★★★☆☆ | ★★★☆☆ |
| 国产硬件适配 | ★★★★★ | ★★☆☆☆ | ★★☆☆☆ |
| 国际社区规模 | ★★☆☆☆ | ★★★★★ | ★★★★☆ |
| 大模型训推一体 | ★★★★★ | ★★★★☆ | ★★★☆☆ |
| 科学计算能力 | ★★★★☆ | ★★★☆☆ | ★★★☆☆ |
本站凯洛导航提供的飞桨 PaddlePaddle都来源于网络,不保证外部链接的准确性和完整性,同时,对于该外部链接的指向,不由凯洛导航实际控制,在2026年10月3日 上午11:10收录时,该网页上的内容,都属于合规合法,后期网页的内容如出现违规,可以直接联系网站管理员进行删除,凯洛导航不承担任何责任。
飞桨完全免费开源,框架和所有官方模型均采用Apache 2.0许可证发布,允许免费商用、修改和分发,无需向百度支付任何费用。星河社区的免费GPU算力也持续向开发者开放,仅在使用更高级的付费算力或企业级服务时需要额外付费。
对于中文母语、没有GPU资源的新手,飞桨的上手门槛更低。官方提供全中文教程、免费在线GPU环境和大量面向初学者的项目实战课程,遇到问题可在中文社区快速获得解答。但若目标是进入国际公司或参与海外开源项目,PyTorch的生态覆盖更广,建议根据职业规划综合选择。
可以。飞桨支持CPU训练和推理,适用于小规模模型和入门学习。此外,飞桨对昆仑芯、海光、寒武纪、昇腾等国产芯片提供完善适配,使用国产显卡同样可以顺畅运行。星河社区还提供免费的在线GPU算力,无需本地显卡也能训练模型。
可以。飞桨3.0专门针对大模型训推做了优化,支持DeepSeek-R1满血版的单机4比特部署,吞吐提升一倍。通过PaddleNLP套件和文心大模型,开发者可以在较低硬件配置下完成大模型的微调和推理部署。
文心大模型是百度的基础大模型产品,飞桨是承载其训练和部署的深度学习框架。两者深度协同:文心大模型的训练基于飞桨框架完成,飞桨也针对文心系列模型做了联合优化。开发者可以通过飞桨的PaddleNLP套件调用和微调文心大模型,实现从框架到模型的全栈开发。