
旷视科技 MEGVII
提供旷视科技的公司介绍、行业解决方案与商务联系信息
 TensorFlow开源机器学习平台
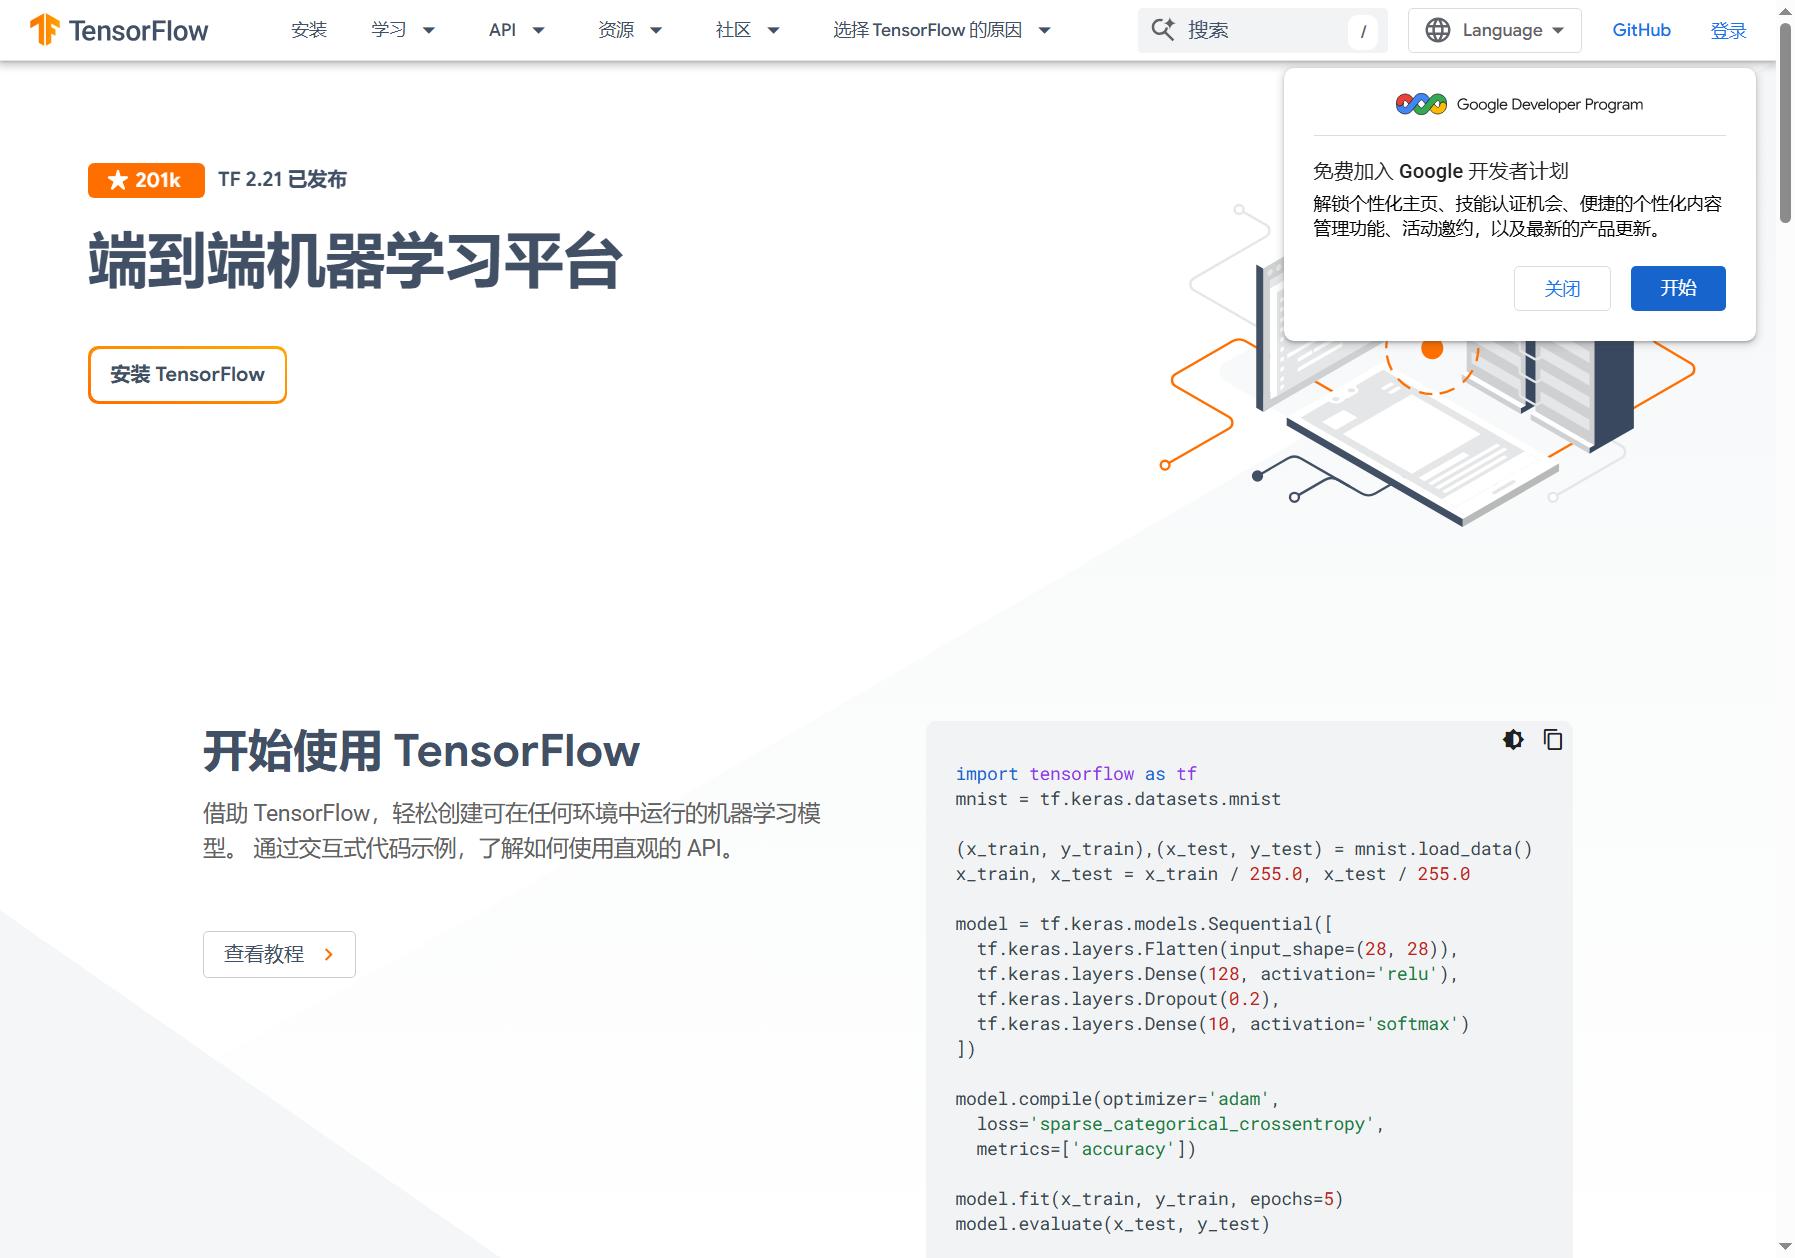
TensorFlow(中文站地址:tensorflow.google.cn)是 Google 于 2015 年 11 月正式开源发布的端到端机器学习平台,由 Google Brain 团队主导开发,后交由 Google 旗下开源社区维护运营。该平台定位为”端到端机器学习平台”,覆盖从数据预处理、模型构建、训练调优到跨端部署的完整工作流,核心目标是让开发者能够用一套代码在不同环境(浏览器、移动端、服务器、边缘设备)中运行机器学习模型。
截至 2026 年,TensorFlow 在 GitHub 上的星标数已超过 19 万,是全球使用最广泛的机器学习框架之一。官方生态包含 TensorFlow.js、LiteRT(原 TensorFlow Lite)、TFX、TensorBoard、tf.data 等数十个子项目,并可无缝对接 Kaggle Models、TensorFlow Datasets 等资源库,预训练模型和标准数据集数量均以千计。
1. 模型构建 API(tf.keras)
tf.keras 是 TensorFlow 的高层 API,用于快速搭建神经网络模型。用户只需像搭积木一样堆叠层(Layer),即可用几行代码定义一个完整的深度学习模型。例如官网首页展示的 MNIST 手写数字识别示例,用 Sequential 模型串联 Flatten、Dense、Dropout 层,配合 compile 与 fit 方法即可完成训练。这种设计大幅降低了建模门槛,同时保留了底层灵活性,适合从原型验证到生产部署的各类场景。
2. 跨平台部署能力
TensorFlow 生态的核心优势在于”一次训练,多端运行”。训练好的模型可以导出为 SavedModel 格式,通过 TensorFlow.js 直接跑在浏览器或 Node.js 中,通过 LiteRT 部署到 Android、iOS、树莓派及 Edge TPU 等边缘设备,也可通过 TensorFlow Serving 部署为云端 API 服务。这一特性让开发者无需为每个目标平台重写推理逻辑。
3. 数据管线与预处理(tf.data)
tf.data 模块提供高效的数据输入管道构建能力。用户可以从内存、本地文件、TFRecord 或云端存储中加载数据,并通过 map、batch、shuffle、prefetch 等操作进行预处理和增强。配合 TensorFlow Datasets 中数百个标准数据集(如图像、文本、音频、视频),新手无需自行收集和清洗数据即可开始训练。
4. 可视化与调试工具(TensorBoard)
TensorBoard 是配套的可视化工具,可在训练过程中实时查看损失曲线、准确率、模型图结构、权重分布直方图等。通过命令行启动后,浏览器访问本地端口即可监控训练进展,帮助开发者快速定位过拟合、梯度消失等问题。
步骤一:安装
打开终端输入 pip install tensorflow 即可安装最新稳定版。CPU 版无需额外配置;如需 GPU 加速,需按官网指南安装 CUDA 与 cuDNN 依赖。Windows、macOS、Linux 均支持。
步骤二:加载数据
以 MNIST 为例,使用 tf.keras.datasets.mnist.load_data() 即可自动下载并拆分训练集和测试集。数据需归一化(除以 255.0)以提升训练稳定性。
步骤三:构建模型
用 Sequential 容器按序添加层,定义输入形状、激活函数和输出维度。常用激活函数包括 relu 和 softmax,后者用于多分类输出。
步骤四:编译与训练
调用 model.compile() 指定优化器(如 adam)、损失函数(如 sparse_categorical_crossentropy)和评估指标。随后 model.fit() 传入训练数据和轮数(epochs)开始训练,每个 epoch 均输出损失和准确率。
步骤五:评估与部署
用 model.evaluate() 在测试集上验证效果。保存模型可执行 model.save('model.h5'),再通过 TensorFlow.js 转换器或 LiteRT 转换工具部署到目标平台。
注意事项:首次训练建议从官方教程的完整代码直接运行,避免手动抄写引入语法错误。遇到 API 报错时,优先查看官方文档右下角的版本切换,确认示例所对应的 TensorFlow 版本与本地一致。
TensorFlow 官网的内容资源由 Google 官方团队维护,权威性和准确性有保障。教程覆盖从零基础入门到专家级进阶,包含交互式代码示例(可直接在浏览器中运行)、图文教程、视频课程及完整的 API 文档。所有资源免费开放,遵循 Apache 2.0 开源协议,可商用、可修改。
更新频率方面,主版本大约每 6—12 个月发布一次,文档与版本保持同步更新。官方博客和 GitHub 仓库会持续发布新特性公告和修复记录。社区贡献方面,Stack Overflow 上的 TensorFlow 标签问题超过 10 万条,中文社区(如哔哩哔哩官方账号)也定期发布教学视频,学习资源供给充足。
适合人群:机器学习初学者、高校学生与研究人员、工业界算法工程师、需要将模型集成到产品中的软件开发者。
场景一:学生入门机器学习
大学生或转行者可用 tf.keras 快速跑通第一个图像分类模型,配合官网的”机器学习速成课程”建立基础认知,无需深入底层数学推导即可完成项目作业或竞赛入门。
场景二:企业端侧 AI 部署
中小型企业需要将训练好的模型上线到手机 App、IoT 设备或网页中时,TensorFlow 的跨平台部署方案(LiteRT、TensorFlow.js)能显著降低接入成本,避免为不同端重写推理代码。
场景三:科研快速实验
研究者可基于 TensorFlow Datasets 和 Kaggle Models 中的预训练模型做迁移学习和微调,快速验证新想法,减少数据准备和从零训练的时间开销。
不适合人群:完全不想写代码的普通用户;对框架灵活性有极高要求、偏好动态图调试的研究者(可优先考虑 PyTorch);仅需调用现成 AI API 而无需自训模型的业务方。
| 维度 | TensorFlow | PyTorch |
|---|---|---|
| 上手难度 | 中等,高层 API 友好但概念较多 | 较低,Pythonic 风格直观 |
| 部署生态 | 强(浏览器/移动端/边缘设备) | 较弱,需配合 ONNX/自研工具 |
| 调试体验 | 2.x 后静态图+动态图混合 | 纯动态图,调试直观 |
| 社区规模 | 大,企业应用积淀深 | 增长快,学术界占优 |
| 文档完善度 | 优秀,官方教程系统 | 优秀,但部分库文档滞后 |
优点:① 端到端方案完整,训练到部署链路成熟;② 生态庞大,配套工具链齐全;③ 官方文档与教程质量高,中文本地化较好;④ 开源免费,商用无版权顾虑。
不足:① 学习曲线相对陡峭,抽象概念(如图执行、张量形状变化)对新手不友好;② API 在 1.x 到 2.x 之间经历大幅变动,网上旧教程容易误导;③ 部分高级功能(如图优化、自定义算子)需要深入底层,排查问题难度较大。
本站凯洛导航提供的TensorFlow开源机器学习平台都来源于网络,不保证外部链接的准确性和完整性,同时,对于该外部链接的指向,不由凯洛导航实际控制,在2026年10月3日 上午10:47收录时,该网页上的内容,都属于合规合法,后期网页的内容如出现违规,可以直接联系网站管理员进行删除,凯洛导航不承担任何责任。
对于完全零编程基础的入门者,PyTorch 的代码风格更贴近 Python 习惯,初始体验更自然。但 TensorFlow 的 tf.keras 高层 API 同样能大幅降低门槛,且官方教程体系更完整、中文本地化更成熟。如果目标是快速跑通模型并部署到产品中,TensorFlow 的生态优势更明显;如果偏重科研探索和灵活调试,PyTorch 可能更顺手。
不需要。TensorFlow 提供 CPU 版本,安装后即可运行大部分教程示例和小型模型。CPU 训练速度较慢,但用于学习和验证代码逻辑完全够用。当模型规模较大或训练时间成为瓶颈时,再按官方指南配置 CUDA 和 cuDNN 启用 GPU 加速即可。
基本不通用。TensorFlow 1.x 使用 Session 和 Graph 的静态图执行模式,代码结构较繁琐;2.x 版本默认启用动态图(Eager Execution),API 也大幅精简。网上大量早期教程基于 1.x,直接复制到 2.x 环境会报错。建议优先查阅 2019 年之后的教程或官方文档,并确认页面标注的版本号与本地安装版本一致。
使用 TensorFlow 生态中的 LiteRT(原 TensorFlow Lite)可将 SavedModel 或 Keras 模型转换为 .tflite 格式,该格式针对移动端和嵌入式设备进行了体积和延迟优化。转换完成后,在 Android 或 iOS 项目中集成 LiteRT 运行时即可加载模型并执行推理。官方提供了完整的转换工具和端侧示例代码。
可以。TensorFlow 核心框架及大部分官方子项目均采用 Apache 2.0 开源许可证,该协议允许商业使用、修改和分发,无需支付授权费用,也无需公开修改后的源码。但需注意:部分 Google 发布的预训练模型可能附带各自的使用条款,商用前应确认具体模型的许可说明。